AI 검색 진단 결과가 매번 다른 것은 진단이 틀려서가 아니라, AI가 답을 ‘확률’로 만들기 때문입니다. ChatGPT나 Gemini는 저장된 순위표를 꺼내 보여 주지 않습니다. 질문을 받을 때마다 가능성 높은 단어와 출처를 골라 답을 새로 만듭니다. 그래서 GEO 진단은 한 번의 화면이 아니라, 여러 번 물어본 결과의 ‘비율’로 봐야 정확합니다.
같은 질문, 얼마나 다른 답이 나올까?
“지난달 진단에서는 우리 브랜드가 나왔는데, 오늘 직접 물어보니 안 나와요.” GEO 상담에서 가장 자주 듣는 말입니다. 검색창에 같은 단어를 치면 비슷한 순위가 나오던 경험에 익숙하다면 당연한 의문입니다.
하지만 AI 검색에서는 이것이 정상입니다. 해외 조사 기관들의 측정 결과를 보면 변화의 폭이 꽤 큽니다.
| 조사 | 측정 내용 | 결과 |
|---|---|---|
| Profound (2025) | 같은 질문, 한 달 간격으로 인용 출처 비교 (플랫폼당 약 8만 개 질문) | 인용 도메인의 40~60%가 바뀜. 6개월 간격이면 70~90% |
| SISTRIX (2026) | 6개국, 17주 동안 매주 같은 질문 반복 (8만여 개 질문) | 일주일 사이 Google AI Mode는 56%, ChatGPT 검색은 74%의 출처가 바뀜 |
| SparkToro·Gumshoe (2026) | 같은 추천 질문을 약 3,000회 반복 | 같은 브랜드 목록이 두 번 나올 확률 1% 미만, 순서까지 같을 확률은 약 0.1% |
같은 질문을 해도 답에 등장하는 브랜드와 출처가 매주, 매달 바뀐다는 뜻입니다. 왜 이런 일이 생기는지는 핀볼 하나로 설명할 수 있습니다.
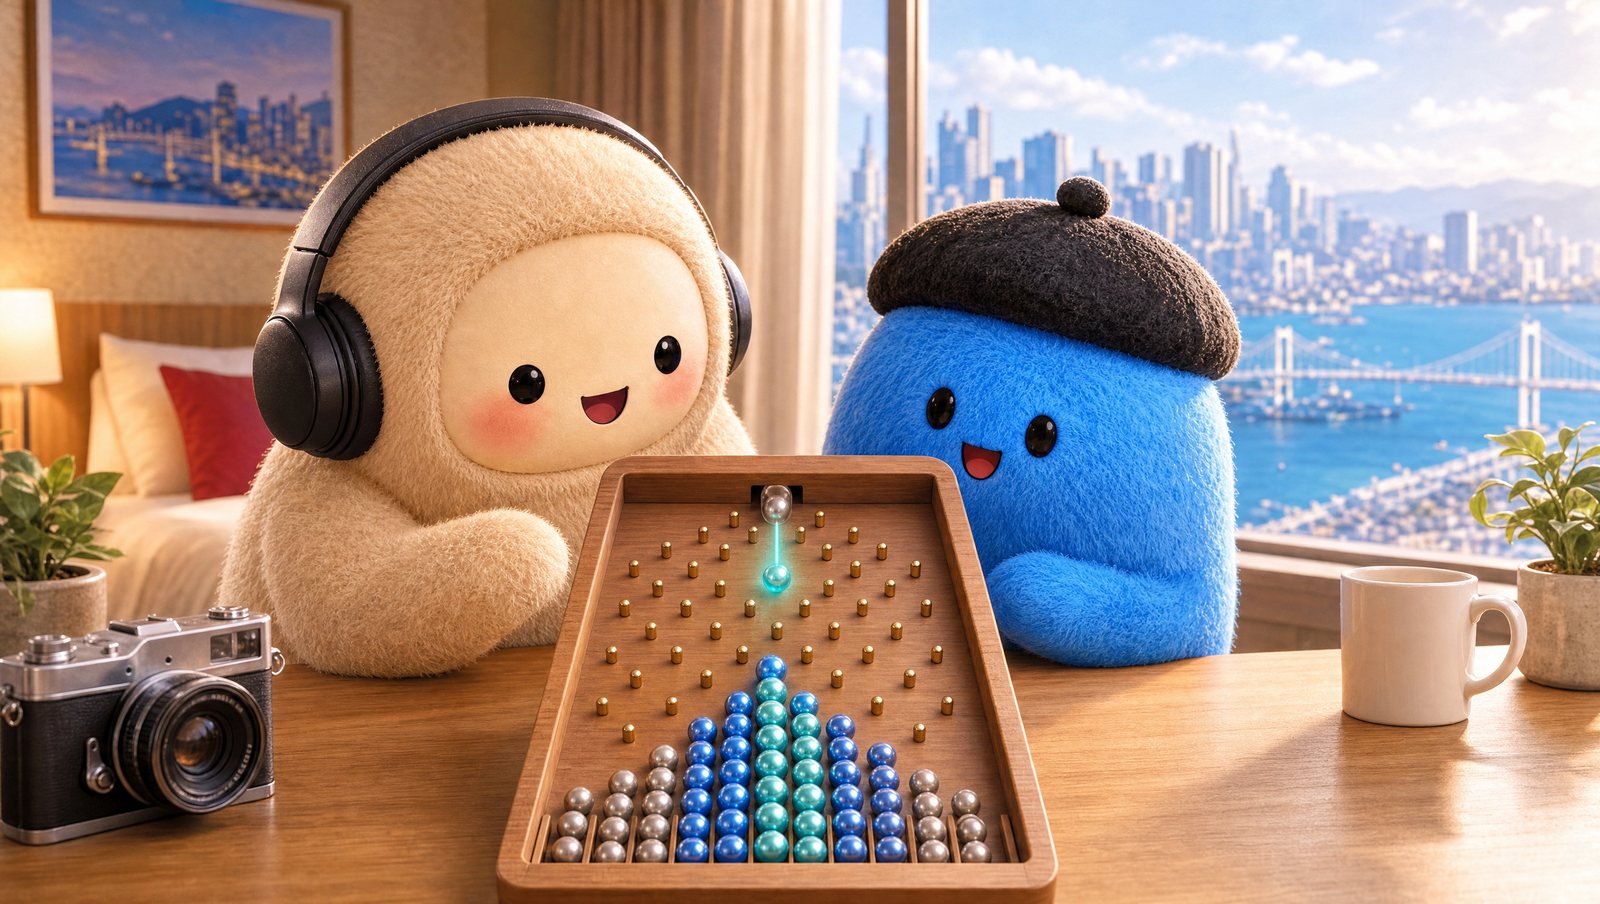
핀볼로 이해하기: 공 하나가 어느 칸에 떨어질지는 아무도 모른다
위에서 공을 떨어뜨리면 공은 수많은 핀에 부딪히며 왼쪽, 오른쪽으로 튀다가 맨 아래 칸 중 하나에 들어갑니다. 같은 자리에서, 같은 방식으로 떨어뜨려도 이번 공이 몇 번 칸에 들어갈지는 미리 알 수 없습니다. 핀에 닿는 각도가 아주 조금만 달라져도 경로가 바뀌기 때문입니다.
그런데 공을 1,000개 떨어뜨리면 이야기가 달라집니다. 공은 칸마다 고르게 흩어지지 않고, 어떤 칸에는 많이, 어떤 칸에는 적게 쌓입니다. 공 하나의 결과는 예측할 수 없지만, 많은 공이 만드는 ‘분포’는 예측할 수 있습니다.
AI 검색도 같습니다.
- 공 하나 = 질문 한 번에 대한 답 하나. 오늘 아침에 직접 물어본 한 번의 결과입니다. 우연이 크게 작용합니다.
- 쌓인 공의 모양 = 여러 번 물었을 때의 언급 비율. “100번 물으면 우리 브랜드가 몇 번 나오는가”입니다. 이것이 진단이 봐야 하는 숫자입니다.
- 칸 = 답에 등장할 수 있는 브랜드와 출처. 우리 브랜드는 그중 한 칸입니다.
그래서 한 번 물어보고 “나왔다” 또는 “안 나왔다”로 판단하는 것은, 공 하나를 떨어뜨려 보고 핀볼 기계 전체를 평가하는 것과 같습니다. 지난달과 오늘의 결과가 다른 것도 공 두 개가 서로 다른 칸에 떨어진 것일 수 있습니다.
AI의 머릿속도 확률로 연결되어 있다
핀볼 비유가 AI에 잘 맞는 이유는 AI의 구조에 있습니다. 우리 뇌에서는 수많은 뉴런이 서로 연결되어 신호를 주고받고, 어떤 연결은 강하고 어떤 연결은 약합니다. ChatGPT 같은 대규모 언어모델(LLM)의 바탕인 인공신경망은 이런 뉴런의 연결 방식에서 아이디어를 얻어 만든 모델입니다. 뇌를 그대로 복제한 것은 아니지만, ‘연결의 세기에 따라 신호가 흘러가는 길이 정해진다’는 원리는 닮았습니다(Neural network (biology)).
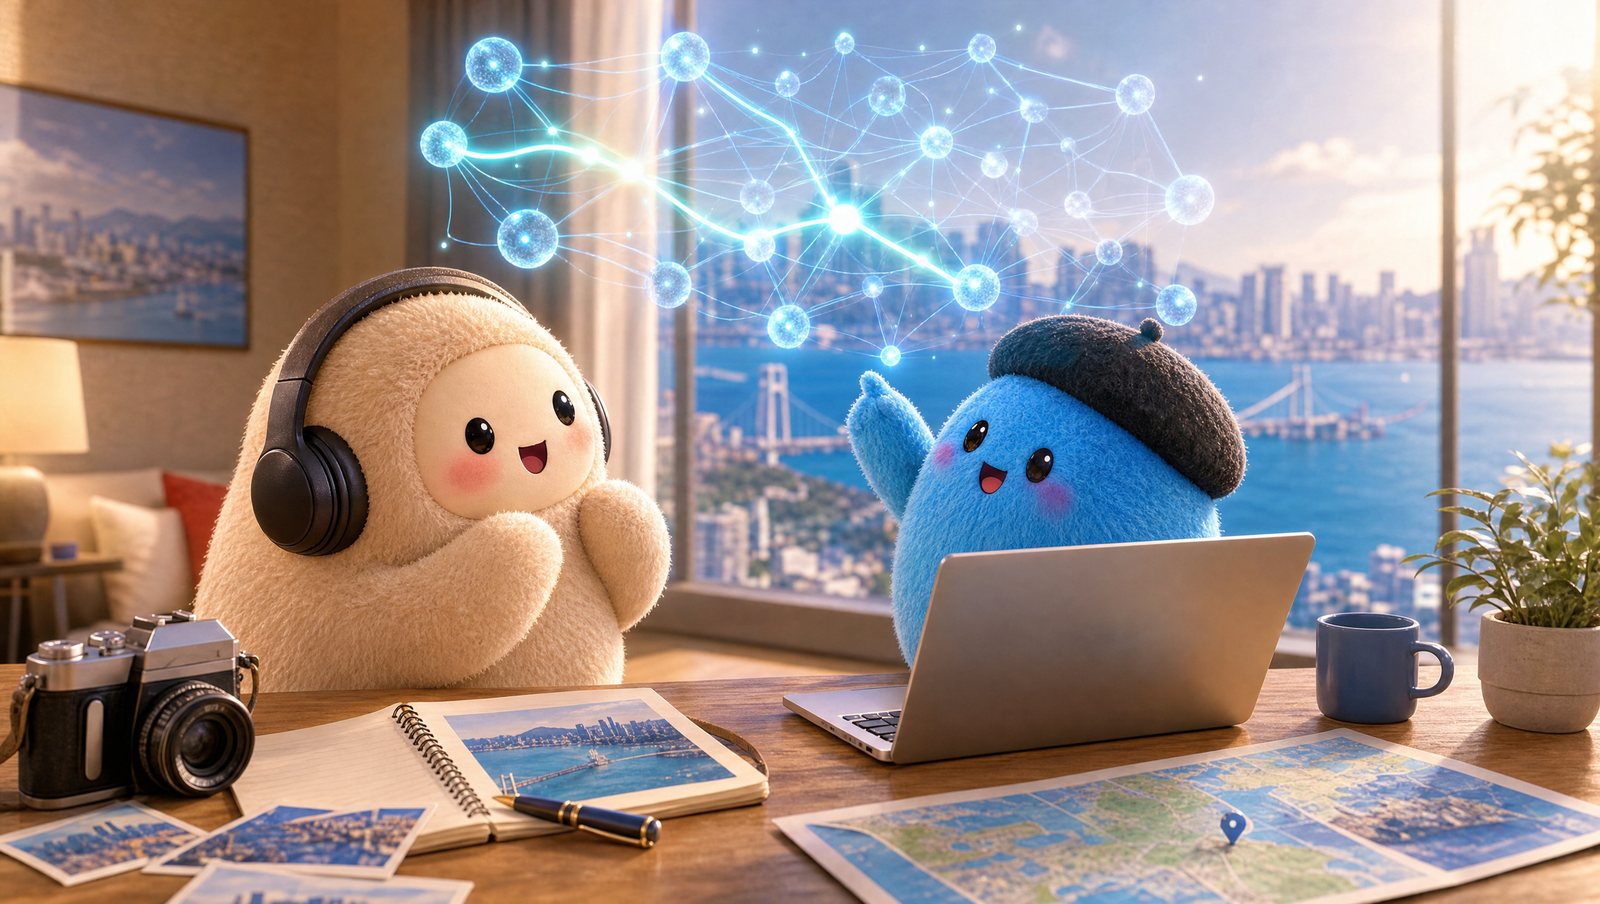
다만 핀볼과 다른 점이 하나 있습니다. 핀볼에서는 공이 핀에 부딪힐 때마다 왼쪽과 오른쪽으로 갈 가능성이 거의 반반입니다. AI는 갈림길마다 후보의 확률이 0.74, 0.03처럼 크게 다르게 매겨집니다. 학습한 내용과 질문의 맥락이 그 확률을 정합니다.
다음 단어도 확률로 고른다
AI는 답을 한 단어(정확히는 ‘토큰’)씩 이어 쓰며, 매번 다음에 올 후보마다 확률을 계산합니다. 예를 들어 “부산에서 바다가 보이는 호텔은” 다음에 올 말을 고를 때 다음과 같은 식입니다.
| 다음에 올 후보 | 확률(예시) |
|---|---|
| 해운대 | 0.74 |
| 광안리 | 0.18 |
| 기장 | 0.05 |
| 송도 | 0.03 |
이해를 돕기 위한 가상 수치입니다.
AI는 대체로 확률이 높은 후보를 고르지만, 늘 1등만 고르지는 않습니다. 답이 매번 똑같이 반복되지 않도록 일정한 무작위성을 두기 때문입니다. 0.18짜리 후보가 선택되면 그 뒤에 이어지는 문장과 등장하는 브랜드도 함께 달라집니다. 핀 하나에서 공이 반대쪽으로 튀면 도착하는 칸이 바뀌는 것과 같습니다.
연구에 따르면 무작위성을 최소로 맞춘 설정에서도 같은 입력에 대한 정확도가 최대 15%까지 흔들렸습니다(Atil 외, 2025). 서버가 여러 사용자의 요청을 묶어 처리하는 방식 같은 기술적 요인도 결과에 영향을 줍니다(Thinking Machines Lab 연구 요약).
출처도 ‘비슷한 정도’로 고른다
AI 검색은 답을 쓰기 전에 웹에서 자료를 찾습니다. 이때 질문을 여러 개의 하위 검색어로 쪼개 동시에 검색하기도 합니다. Google은 이를 ‘쿼리 팬아웃’이라고 부릅니다(Google Search Central). 그렇게 모은 후보 중에서 질문과 의미가 얼마나 가까운지, 즉 유사도가 높은 자료를 골라 인용합니다.
여기에도 확률이 끼어듭니다. 하위 검색어가 매번 조금씩 다르게 만들어질 수 있고, 검색 결과도 계속 바뀝니다. 같은 질문이라도 사람마다 쓰는 말투와 단어가 달라, 뜻이 같아도 결과가 크게 달라질 수 있다는 연구도 있습니다(Sclar 외, ICLR 2024).
그렇다면 GEO는 무엇을 하는가: 공이 우리 칸에 더 자주 떨어지게 만든다
결과가 확률로 정해진다고 해서 할 수 있는 일이 없는 것은 아닙니다. 핀볼에서 핀의 배치를 바꾸면 공 하나의 행방은 여전히 알 수 없어도, 공이 특정 칸에 더 많이 쌓이게 만들 수 있습니다. GEO(Generative Engine Optimization, 생성형 엔진 최적화)가 하는 일이 바로 이것입니다.
- AI가 찾을 수 있게 하기. 고객사 웹사이트가 AI 검색의 후보에 들어가도록 구조와 정보를 정리합니다. 질문에 바로 답하는 문장, 정확한 사실, 명확한 출처가 핵심입니다.
- AI가 믿고 인용할 출처 늘리기. AI는 자사 사이트뿐 아니라 매체, 리뷰, 전문 콘텐츠를 함께 참고합니다. 고객이 실제로 묻는 질문에 답하는 외부 콘텐츠가 많을수록 우리 칸으로 향하는 길이 늘어납니다.
- 같은 기준으로 다시 재기. 실행 전과 후를 같은 질문, 같은 조건으로 측정해 확률이 실제로 올라갔는지 확인합니다.
GEO라는 개념을 처음 제안한 프린스턴대 등의 연구진은 출처 인용, 통계, 인용문 추가 같은 방법으로 AI 답변 속 가시성을 최대 40%까지 높일 수 있음을 보였습니다. 동시에 효과는 분야마다 달랐다고 밝혔습니다(Aggarwal 외). GEO는 결과를 ‘확정’하는 일이 아니라 ‘확률을 높이는’ 일이라는 뜻입니다.
좋은 진단은 공을 여러 번 떨어뜨린다
그렇다면 믿을 수 있는 진단은 어떻게 알아볼까요? 미국 인터랙티브광고협회(IAB)는 2026년 8월 AI 가시성 측정 기준을 발표했습니다. 이 기준은 처음부터 “AI는 같은 질문에도 다른 답을 낸다”를 전제로 만들어졌습니다(IAB).
IAB 기준을 바탕으로, GEO 진단을 받을 때 확인할 다섯 가지를 정리했습니다.
- 질문마다 여러 번 물어봤는가? IAB는 질문당 응답 하나로 낸 수치는 ‘표본 하나’일 뿐이라고 봅니다. 여러 번 물어 비율을 내야 합니다.
- 질문 수가 충분한가? IAB는 질문 50개 미만의 측정을 ‘탐색’ 수준으로 분류합니다.
- 질문의 종류가 고른가? 정보형(“OO란?”), 비교형(“A와 B 차이”), 추천형(“OO 추천”), 구매형(“어디서 사나”)이 고루 들어가야 한 가지 유형에 치우친 결과를 피할 수 있습니다.
- AI 서비스별, 국가·언어별로 따로 보여 주는가? 같은 질문이라도 ChatGPT와 Google AI Mode는 서로 다른 출처를 인용하고, 같은 질문도 나라마다 답이 다릅니다. 하나의 점수로 합치면 차이가 가려집니다.
- 숫자를 범위로 말하는가? IAB는 “점유율 22%”보다 “약 22%, ±4%p”처럼 범위로 보고하는 편이 의사결정에 더 유용하다고 권고합니다. 범위 안의 오르내림은 의미 있는 변화가 아닙니다.
“노출 보장”이라는 말을 조심해야 하는 이유
AI 검색을 운영하는 회사들도 노출을 약속하지 않습니다. Google은 모든 요건을 지켜도 색인과 노출이 보장되지 않는다고 안내합니다(Google Search Central). OpenAI도 ChatGPT 검색에서 상위 노출을 보장할 방법은 없다고 밝힙니다(OpenAI Help).
플랫폼도 정할 수 없는 결과를 약속하기보다, 무엇을 실행하고 어떻게 측정할지를 분명히 정하는 편이 고객사에 더 정직하고 유용합니다. 좋은 GEO 파트너에게 물어야 할 질문은 “몇 위에 올려 주나요?”가 아니라 “어떤 기준으로 재고, 무엇을 바꿔서 확률을 높이나요?”입니다.
자주 묻는 질문
직접 ChatGPT에 물어봤더니 진단 결과와 달라요. 진단이 틀린 건가요?
아닙니다. 한 번 물어본 결과는 핀볼 공 하나와 같아서 우연이 크게 작용합니다. 진단은 여러 질문을 여러 번 물어 본 비율이므로, 한 번의 결과와 다를 수 있습니다.
진단할 때마다 수치가 조금씩 바뀌는데 괜찮은가요?
정상입니다. 해외 조사에서는 같은 질문의 인용 출처가 한 달 사이 40~60% 바뀌었습니다. 중요한 것은 평소 변동 범위를 넘는 변화인지, 그리고 여러 달에 걸친 추세가 어느 방향인지입니다.
AI 순위 1위를 목표로 할 수 있나요?
AI 답변 속 순서는 매번 크게 바뀌어 안정적인 지표가 되기 어렵습니다. 대신 “같은 의도의 질문에서 우리 브랜드가 얼마나 자주 언급되고 인용되는가”를 목표로 삼는 것이 측정 가능하고 의미 있습니다.
GEO 성과를 보장받을 수 있나요?
Google과 OpenAI도 노출을 보장하지 않는다고 공식 안내합니다. GEO는 인용될 확률을 높이는 실행과, 그 변화를 같은 기준으로 측정하는 일입니다. 계약할 때는 실행 범위와 측정 방법을 구체적으로 확인하는 것이 좋습니다.
그럼 결과를 어떻게 믿을 수 있나요?
질문 수, 질문당 반복 횟수, 측정 기간, AI 서비스·국가별 결과, 수치의 범위를 공개하는 진단이라면 믿을 수 있는 근거를 갖춘 것입니다.
한 줄 요약
AI 검색은 핀볼처럼 공 하나의 행방은 알 수 없지만, 많이 떨어뜨리면 분포가 보이고, GEO는 그 분포가 우리 브랜드 쪽으로 기울도록 핀의 배치를 바꾸는 일입니다.
참고 자료
- IAB, Measuring Visibility in the AI Era (2026.8)
- Profound, AI Search Volatility (2025.7)
- SISTRIX, AI Citation Drift (2026.5)
- Search Engine Land, SparkToro·Gumshoe 연구 보도
- Aggarwal 외, GEO: Generative Engine Optimization
- Atil 외, Non-Determinism of “Deterministic” LLM Settings
- Sclar 외, Sensitivity to Spurious Features in Prompt Design
- Google Search Central, AI features and your website
- OpenAI Help, ChatGPT search